
什么是DigitalOcean?
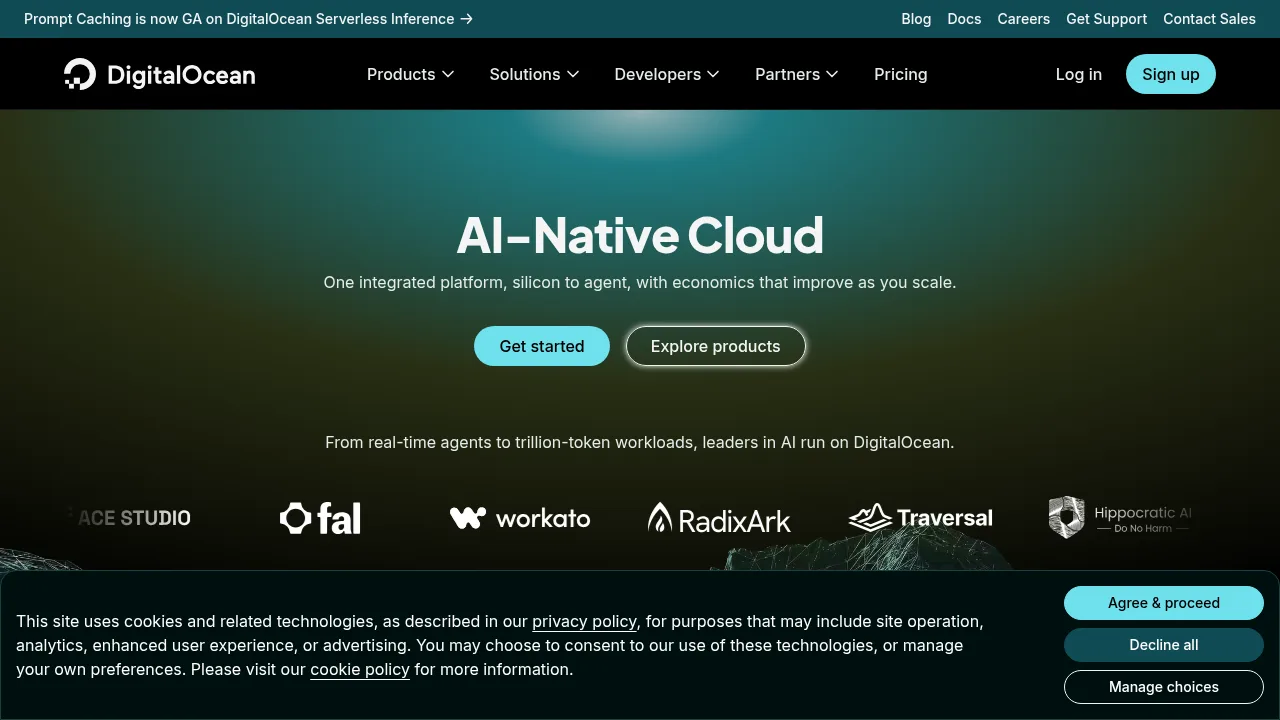
DigitalOcean 是一个集成云平台,供开发者构建、运行和扩展应用程序及 AI 代理。它在一个账户中统一提供计算、推理、数据库和网络服务,支持从实时代理到大规模工作负载的场景。
DigitalOcean的核心功能有哪些?
- 托管代理运行时在隔离的 MicroVM 中运行用户自带的代理框架(如 LangGraph, CrewAI),空闲时自动暂停以节省算力成本。
- 服务器端推理通过共享端点调用 85+ 开源及前沿模型,按 Token 计费并支持缩容至零,无需管理 GPU 基础设施。
- 专用推理与 BYOM在数字海洋管理的 GPU 上运行模型,或导入 Hugging Face 上的 Safetensors 权重进行自定义部署。
- 数据服务集成提供向量数据库、知识基座及关系型数据库,使代理能在同一网络区域内直接访问私有数据。
- 智能路由优化Inference Router 根据任务定义自动选择成本或速度最优的模型,并在代码不变的情况下切换底层模型。
DigitalOcean的使用案例有哪些?
- 原型开发与突发流量处理利用 Serverless Inference 快速测试模型效果,应对不稳定的请求量而无需预置硬件。
- 生产级 AI 代理部署将代理逻辑、推理服务和数据存储整合在同一云环境,避免跨供应商的数据传输延迟和费用。
- 高吞吐量模型服务针对 DeepSeek 等大参数模型,使用 Dedicated Inference 获得比标准 API 更高的吞吐量和更低延迟。
如何使用DigitalOcean?
- 创建资源注册 DigitalOcean 账户,并根据需求选择 Droplet、Managed Agents 或 Inference Engine 产品。
- 配置代理若使用 Managed Agents,上传或连接现有的代理框架代码(如 Claude Code 或 OpenCode)。
- 设置推理端点在 Model Library 中选择所需模型,获取 API Key 并配置 OpenAI 兼容的接口地址。
- 关联数据源在相同区域内部署 Vector Database 或 Knowledge Base,并通过私有网络将数据访问权限授予代理。
- 监控与优化使用 Insights 和 Signals 工具记录代理行为并评估性能,根据反馈调整模型选择或提示词。
DigitalOcean定价信息:
- Serverless Inference按 Token 使用量付费,支持缩容至零,适合原型开发和间歇性流量。
- Dedicated Inference / GPU Droplets基于预留 GPU 资源的计费模式,适合需要稳定性能和低延迟的生产工作负载。
- Managed Agents仅对实际使用的计算时间收费,代理空闲时不计费。