
¿Qué es Liquid AI?
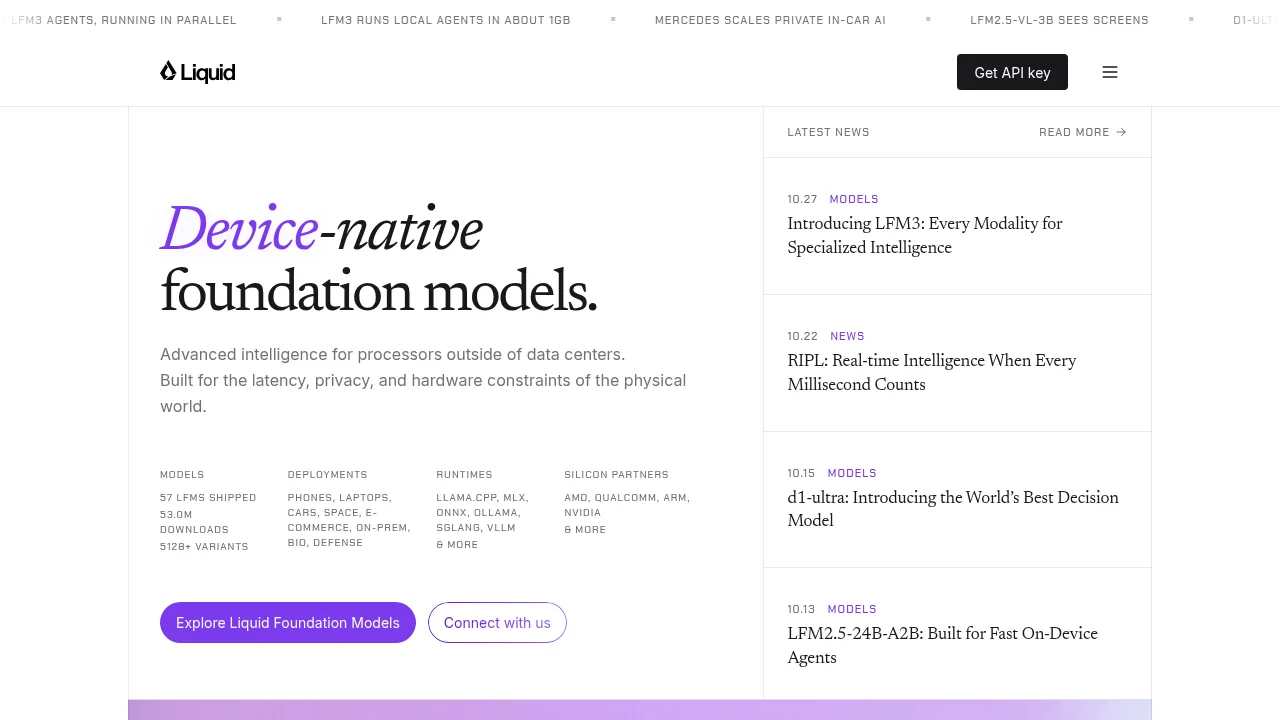
Liquid AI ofrece modelos de fundación nativos para dispositivos, diseñados para ejecutarse localmente en teléfonos, ordenadores y vehículos sin depender de centros de datos. La plataforma prioriza la privacidad al mantener los datos en el dispositivo y reduce la latencia mediante arquitecturas optimizadas para hardware específico. El acceso a las capacidades avanzadas requiere una clave de API o la descarga directa de los modelos para su despliegue propio.
¿Cuáles son las características de Liquid AI?
- Ejecución local en dispositivosLos modelos LFM3 operan directamente en el hardware del usuario con un consumo aproximado de 1 GB de memoria, eliminando la necesidad de conexión constante a la nube.
- Modelos de decisión d1-ultraDiseñado para automatizar decisiones en menos de 50 ms, este modelo está disponible vía API y destaca por su velocidad de respuesta en entornos de tiempo real.
- Visión computacional en el bordeModelos como LFM2.5-VL-3B permiten que los dispositivos interpreten pantallas y contenido visual localmente, ofreciendo hasta tres veces más rapidez en equipos Mac.
- Compatibilidad con múltiples runtimeSoporta integración con frameworks estándar como llama.cpp, MLX, ONNX, Ollama, SGLang y vLLM, facilitando la adaptación a distintos ecosistemas técnicos.
- Colaboración con fabricantes de chipsCo-diseño de modelos con socios como AMD, Qualcomm, Arm y NVIDIA para optimizar el rendimiento según las limitaciones físicas del procesador.
¿Cuáles son los casos de uso de Liquid AI?
- Asistentes personales en SnapdragonIntegración de contexto de IA personal en dispositivos móviles potenciados por Qualcomm, permitiendo procesamiento local inmediato.
- Experiencias multimodales en vehículosUso privado de reconocimiento de voz y lenguaje dentro del coche, como se implementa en colaboración con Mercedes-Benz, sin enviar datos externos.
- Agentes autónomos en e-commerceDespliegue de agentes especializados para Shopify que operan bajo restricciones de coste y latencia mediante modelos pareto-óptimos.
¿Cómo usar Liquid AI?
- Obtener accesoSolicitar una clave de API para servicios gestionados o descargar los modelos desde GitHub o Hugging Face para uso local.
- Seleccionar modeloElegir entre variantes como LFM2.5-24B-A2B para agentes rápidos o d1-ultra para decisiones críticas según los requisitos de hardware.
- Integrar runtimeConfigurar la ejecución utilizando uno de los soportes compatibles como llama.cpp, MLX u ONNX según la plataforma destino.
- Desplegar en dispositivoEjecutar la inferencia localmente verificando que los recursos de memoria (aproximadamente 1 GB) sean suficientes para el modelo seleccionado.