
什么是DocAnalyzer?
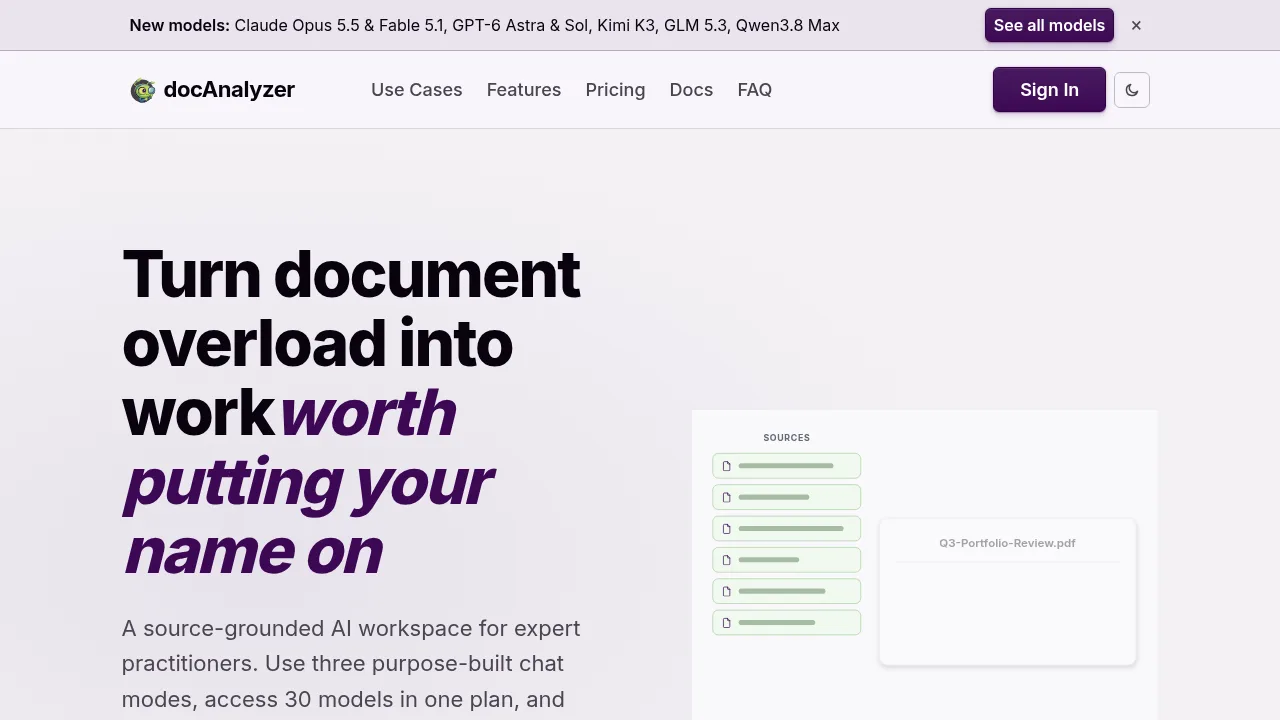
DocAnalyzer 是一个面向专业人员的基于来源的 AI 文档工作区,支持通过三种聊天模式处理多格式文档。用户可在单一计划中访问30种模型,生成的工件(如表格、图表)可跨对话轮次复用和转换。首次使用无需信用卡,注册后约30秒即可开始会话。
DocAnalyzer的核心功能有哪些?
- 多步代理引擎将 PDF、XLSX、HTML 等作为一等输出,支持在对话中生成、引用并组合成新的分析任务。
- 上下文保留与工件复用早期轮次生成的文件(如电子表格)可在后续轮次转换为其他格式或作为新分析的输入,避免重复劳动。
- 严格来源引用控制提供上下文依从性调节器,用户可设定回答是否严格限制在上传源内;每个引用均可点击跳转至原文确切页面。
- 多模型无缝切换集成11家提供商的30个模型,允许在对话中途切换模型而不重置代理或丢失上下文。
- 大规模文档库处理不受LLM单次上下文窗口限制,可通过多轮检索读取数百份长文档,并按需调整工作集大小。
- 自动OCR与混合语言支持自动对扫描页进行40+种语言的OCR识别;支持混合语言文档库,可用一种语言提问并获取另一种语言的原文引用。
DocAnalyzer的使用案例有哪些?
- 合同批量审查针对大量商业协议提取特定条款字段,替代人工逐页阅读以缩短项目周期。
- 学术资料对比同时上传多份大型密集文档,在不同论文间交叉验证观点或术语定义。
- 简历与职位匹配结合职位描述与候选人简历进行比对分析,辅助招聘决策。
如何使用DocAnalyzer?
- 注册账户创建免费账户,无需信用卡,约30秒后可开始首次会话。
- 上传文档将PDF、Word、Excel等文件拖入工作区,系统自动对扫描页执行OCR。
- 选择模式根据需求选择“Ask docAnalyzer”(规划步骤)、“Focus chat”(深度分析)或“Co-work chat”(结构化编辑)。
- 调整设置如需高准确性,调高上下文依从性控制以严格限制模型仅依据源文档回答。
- 导出工件下载生成的PDF、电子表格或图表,或在后续轮次中将其作为新分析的输入。
DocAnalyzer定价信息:
- 免费层级涵盖日常文档问答及核心工作区功能,包含有限制的每日提示用量和存储额度。
- 付费层级解锁更大的文件页数/存储限制、高级模型访问权、超出免费额度的批量工作流以及团队工作区功能。