
什麼是DocAnalyzer?
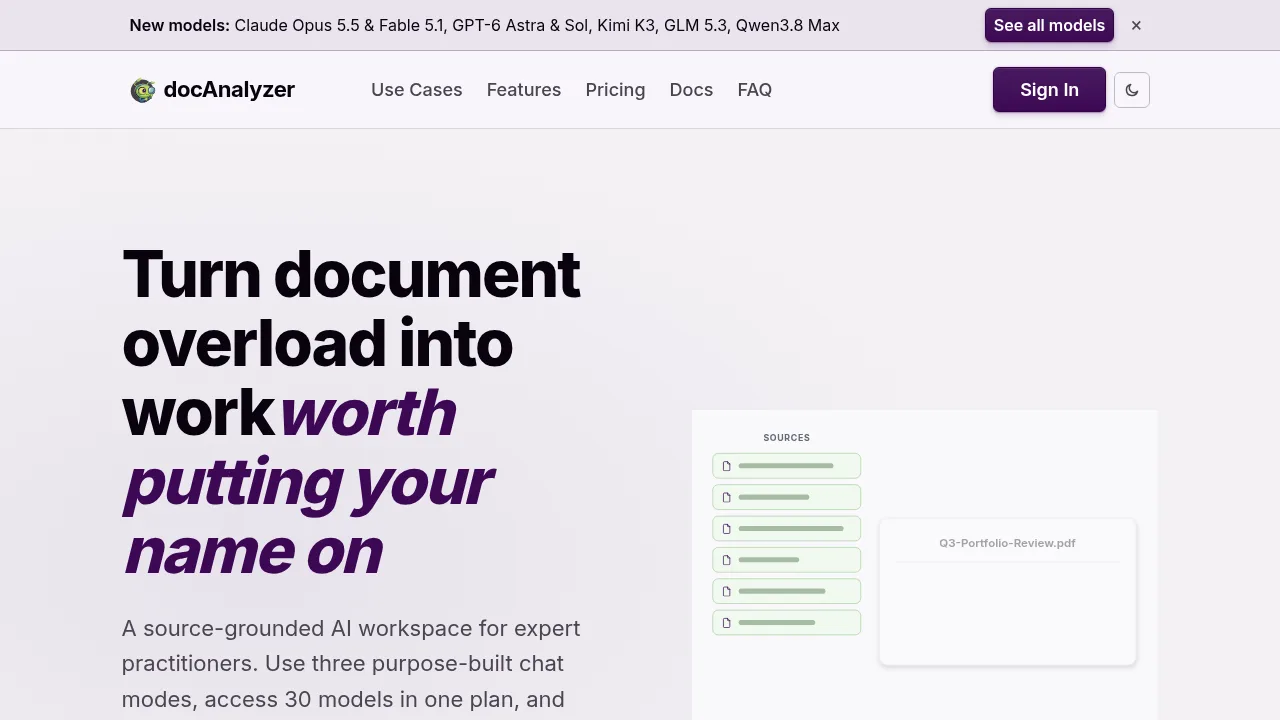
DocAnalyzer 是一個源於文件的 AI 工作區,主要用於處理大量文件並生成可下載的工件(如 PDF、Excel)。它支援跨多輪對話保留上下文,讓前一次生成的檔案能作為後續分析的輸入。使用者需註冊帳戶使用,免費方案涵蓋基本問答與核心工作區功能。
DocAnalyzer的特色是什麼?
- 多模型切換介面整合來自 11 家供應商的 30 種模型,可在同一對話中切換而不中斷代理程式或遺失上下文。
- 三種專用聊天模式包含規劃下一步的 Ask docAnalyzer、針對特定來源深度分析的 Focus chat,以及在結構化畫布編輯器中優化輸出的 Co-work chat。
- 可重複使用的工件輸出系統可將對話中的輸出(如電子表格)轉換為新格式(如 PDF、ZIP),並作為新分析的輸入,避免重複工作。
- 嚴格來源追蹤引用每個引用的主張都連結到確切的頁面或章節,點擊即可開啟文件檢視器驗證上下文,防止幻覺。
- 大規模文件庫處理不受限於單一模型的上下文視窗,透過多輪檢索與閱讀處理數百份長篇文件及混合格式資料集。
- 自動 OCR 文字辨識掃描頁面會自動進行 OCR 處理以確保文字可搜尋,支援超過 40 種語言的掃描文件辨識。
DocAnalyzer的使用案例有哪些?
- 合約條款差異分析比較不同年份的申報文件或審查大量商業協議,找出偏離標準賠償條款的內容,並生成帶引用的備忘錄。
- 跨語言文件綜合在單一資料庫中混合多種語言的文件,用英文提問關於阿拉伯文原始資料的問題,答案會引用回原文並翻譯。
- 批量文件結構化提取針對每份文件執行獨立的工作流程,從數百份文件中提取特定欄位並返回結構化結果,適用於審計或數據整理。
如何使用DocAnalyzer?
- 上傳文件將 PDF、Word、Excel 或其他支援格式的文件拖曳至 DocAnalyzer 網頁版工作區。
- 選擇模式與模型根據任務需求選擇 Ask、Focus 或 Co-work 聊天模式,並從可用的 30 個模型中挑選適合的 AI 引擎。
- 設定上下文依從性調整 context-adherence 控制項,決定是嚴格限制在來源內還是允許更廣泛的綜合知識。
- 生成與迭代工件要求系統產生圖表、表格或報告,並利用先前生成的檔案作為新回合的輸入進行進一步分析。
- 匯出最終成果下載生成的 PDF、XLSX、HTML 或 ZIP 檔案,這些檔案保留了完整的來源引用鏈。
DocAnalyzer定價信息:
- 免費方案無需信用卡即可開始,涵蓋日常文件問答和核心工作區功能,但對單檔大小、頁數、總儲存量和每日提示使用量有限制。
- 付費方案解鎖更大的使用限制、高級模型存取、超出包含額度之外的批次工作流程,以及團隊工作區功能;具體價格與詳細限制請參考定價頁面。