Was ist Dagster?
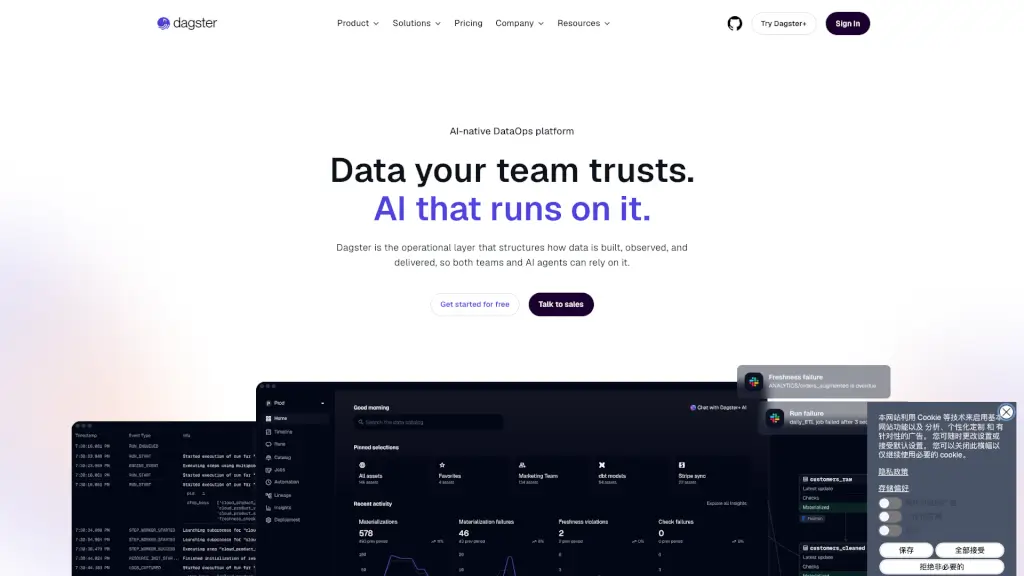
Dagster ist eine moderne Data-Orchestrierungsplattform, die Teams dabei hilft, zuverlässige Datenpipelines schnell und flexibel zu bauen, zu planen und zu überwachen. Statt nur Aufgaben abzuarbeiten, fokussiert sich Dagster auf Daten-Assets – also die tatsächlichen Tabellen, Modelle oder Berichte, die Ihr Team nutzt. Dadurch entsteht ein klares Bild von Herkunft (Lineage), Abhängigkeiten und Datenqualität.
Besonders in Zeiten von KI und Echtzeit-Analysen brauchen Unternehmen eine vertrauenswürdige Dateninfrastruktur. Dagster liefert genau das: eine einheitliche Plattform, auf der Entwickler, Analysten und sogar KI-Agenten gemeinsam auf verlässlichen Daten arbeiten können – ohne ständig Fehler nachzujagen oder manuelle Prozesse zu pflegen.
Was sind die Merkmale von Dagster?
- Asset-basierte OrchestrierungPipelines werden anhand der erzeugten Daten-Assets definiert – nicht als reine Aufgabenabfolge. So wird Lineage automatisch erfasst.
- Integrierter Data Catalog & QualitätDatenherkunft, Abhängigkeiten und Qualitätsmetriken sind direkt in der Plattform sichtbar – kein separates Tool nötig.
- Dagster+ AINutzt den bestehenden Kontext (wie Ausführungsverlauf oder Fehlermuster), um Teams bei Diagnose und Automatisierung zu unterstützen.
- Native IntegrationenFunktioniert nahtlos mit dbt, Snowflake, Fivetran und vielen anderen Tools – ohne selbst gebaute „Glue“-Skripte.
- Hybride BereitstellungRechenlast läuft in Ihrer eigenen Infrastruktur (Cloud, On-Prem oder hybrid), während Dagster die Steuerung übernimmt.
- Branch DeploymentsÄnderungen an Pipelines können sicher in produktionsnahen Umgebungen getestet werden – ohne Live-Daten zu gefährden.
- Open Source KernDer Hauptteil von Dagster ist Open Source (auf GitHub verfügbar); Dagster+ bietet zusätzliche Enterprise-Funktionen als Cloud-Dienst.
Was sind die Anwendungsfälle von Dagster?
- ETL/ELT-Pipelinesmodernisieren und mit vollständiger Sicht auf Datenherkunft und Fehlerursachen betreiben
- KI- und ML-Workflowsorchestrieren, bei denen Datenqualität und Aktualität entscheidend sind
- Datenplattformen für mehrere Teamsskalieren – mit gemeinsamen Standards, aber eigenständiger Entwicklung
- dbt-Modelle(über 1.000!) automatisieren und zentral überwachen – ohne Downtime
- Manuelle Operationstätigkeiteneliminieren und bis zu 8 Stunden pro Woche sparen
- Entwickler-Onboardingvon Monaten auf einen Tag verkürzen durch klare Strukturen und Dokumentation im Code
- Business-kritische Datendeutlich schneller bereitstellen – z. B. von 7 Stunden auf 30 Minuten Frische
Wie benutzt man Dagster?
- Starten Sie kostenlosmit Dagster+ oder installieren Sie die Open-Source-Version lokal
- Nutzen Sie Dagster University, um die Grundlagen zu lernen – inklusive praktischer Kurse
- Integrieren Sie bestehende dbt-Projekte oder Snowflake-Assets mit wenigen Codezeilen
- Definieren Sie Ihre Pipelines asset-basiert, um automatisch Lineage und Abhängigkeiten zu erhalten
- Testen Sie Änderungen mit Branch Deployments, bevor sie in Produktion gehen
- Aktivieren Sie Dagster+ AI (in der Cloud-Version), um intelligente Diagnosen und Aktionen zu nutzen