
Was ist Avian.io?
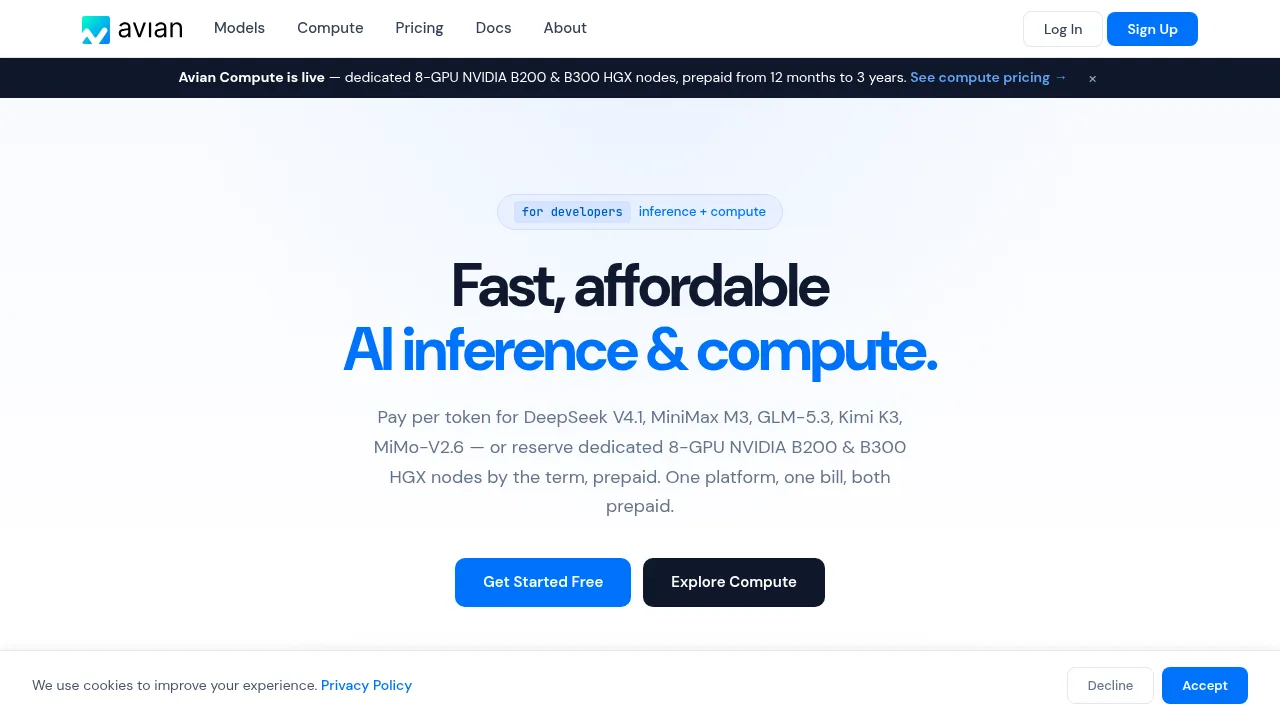
Avian.io ist eine Plattform für Entwickler, die KI-Inferenz-APIs und dedizierte GPU-Rechenkapazität bereitstellt. Nutzer können über einen OpenAI-kompatiblen Endpoint auf Modelle wie DeepSeek V4.1 zugreifen oder NVIDIA B200/B300 HGX-Knoten mieten. Der Zugang erfolgt per API-Schlüssel mit nutzungsbasierter Abrechnung oder als Vorabzahlung für Hardware-Ressourcen.
Was sind die Merkmale von Avian.io?
- OpenAI-kompatible APIErmöglicht den Austausch von OpenAI durch Avian mit einer einzigen Codezeile; unterstützt Streaming und Chat-Completions.
- Modellzugang via Einzel-KeyZugriff auf Frontier-Modelle wie DeepSeek V4.1, MiniMax M3, GLM-5.3, Kimi K3 und MiMo-V2.6 ohne separate Schlüsselverwaltung.
- Dedizierte GPU-KnotenBereitstellung von vollständigen 8-GPU NVIDIA B200 oder B300 HGX Nodes als Single-Tenant-Lösung mit NVLink-Domain.
- Spekulative DekodierungBeschleunigte Inferenz auf NVIDIA B200 GPUs, um niedrige Latenzzeiten für Echtzeit-Anwendungen zu erreichen.
- Tool-IntegrationKompatibilität mit über 20 Coding-Tools wie Cursor, Claude Code, Cline und Windsurf.
- DatensicherheitKeine Datenspeicherung nach Anfragen; Infrastruktur auf Microsoft Azure mit SOC/2-Zertifizierung und GDPR/CCPA-Konformität.
Was sind die Anwendungsfälle von Avian.io?
- KI-gestützte SoftwareentwicklungBeschleunigung von Autocomplete-Funktionen in IDEs wie Cursor und Agenten-Iterationen in Tools wie Claude Code dank hoher Token-Ausgabegeschwindigkeit.
- Skalierung von ProduktionslastenÜbergang von serverloser API-Nutzung zu dedizierten GPU-Knoten bei steigenden Anforderungen an Durchsatz und Kontrolle.
- Kosteneffiziente ModellnutzungNutzung von Modellen wie DeepSeek V4.1 Flash für Aufgaben, bei denen niedrige Kosten pro Million Tokens im Vordergrund stehen.
Wie benutzt man Avian.io?
- API-Schlüssel generierenRegistrierung auf der Plattform zur Erstellung eines eindeutigen API-Keys.
- Client konfigurierenInstallation des OpenAI-Python-Clients und Festlegung der Base-URL
https://api.avian.io/v1. - Modell auswählenSpezifikation eines unterstützten Modells (z. B.
deepseek/deepseek-v4.1-flash) in der Request. - Inferenz ausführenSenden der Nachricht und Empfangen der Antwort, optional mit aktiviertem Streaming.
Avian.io Preisinformationen:
- Serverless Inference APIPay-as-you-go Preismodell ab $0.1275 pro Million Input-Tokens (DeepSeek V4.1 Flash); keine Mindestabnahme, keine Ratenlimits.
- Dedicated GPU ComputeVorabzahlung für 8-GPU NVIDIA B200/B300 HGX Nodes ab $3.42 pro GPU-Stunde; Vertragslaufzeiten von 12 Monaten bis 3 Jahren.