什么是Whisper Web?
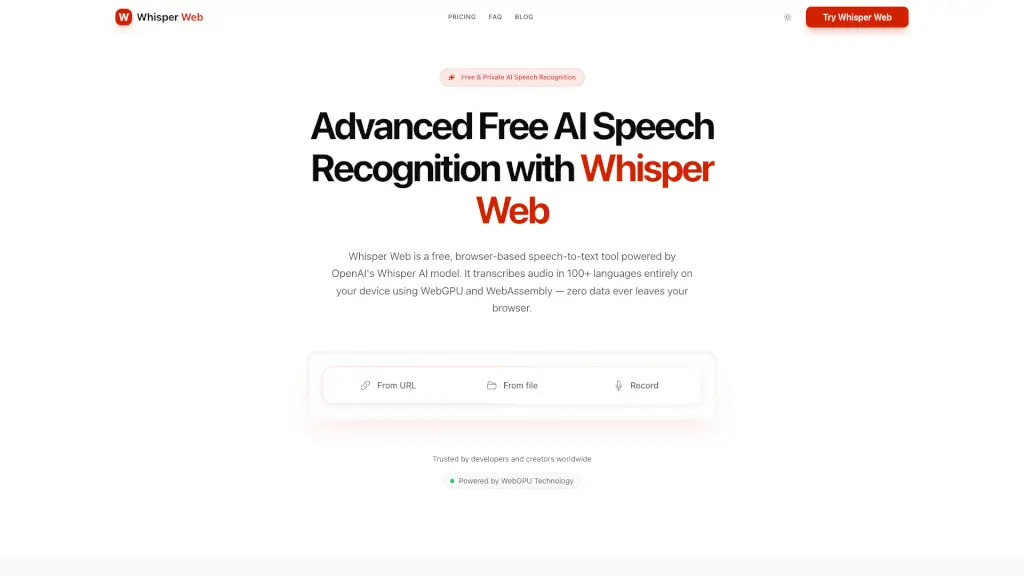
Whisper Web 是一款基于浏览器的 AI 语音识别工具,利用 OpenAI 的 Whisper 模型在本地设备上完成转写。它主要面向需要快速、私有地将音频转为文本的用户,比如记者、学生、播客制作者和内容创作者。核心价值在于所有音频处理都在浏览器内完成,无需上传到服务器,数据完全留在本地,适合对隐私要求高的场景。用户只需打开网页即可使用,无需安装或注册。
Whisper Web的核心功能有哪些?
- 本地离线处理:所有音频转写在用户设备上通过 WebGPU 和 WebAssembly 完成,无需联网(首次加载模型后)。适合在无网络环境或注重隐私的场景下使用。
- 多输入方式:支持麦克风实时录音、上传音频文件、以及通过 URL 或浏览器音频直接转写,覆盖不同使用习惯。
- 100+语言支持:自动检测并转写超过100种语言,包括英语、中文、西班牙语、法语、日语等,无需手动选择语言。
- WebGPU 加速:利用设备 GPU 提升转写速度,比纯 CPU 处理快3-5倍,适合长音频或批量处理需求。
- 多种导出格式:转写结果可导出为 TXT、SRT、VTT、JSON 格式,适配字幕制作、文档整理、数据分析等不同工作流。
- 免费模式限制:免费版支持文件最大200MB、时长20分钟,无转写次数限制;付费不限量版支持单文件10小时/5GB,并可批量上传50个文件。
Whisper Web的使用案例有哪些?
- 播客制作者:将录制好的播客音频上传到 Whisper Web,自动转写为文字稿,然后导出为 SRT 或 VTT 格式制作字幕,无需第三方服务。
- 学生听课:用麦克风实时录制课堂内容,转写为笔记,导出 TXT 保存到本地,避免打字遗漏重点。
- 记者采访:上传采访录音文件(MP3等),自动识别说话人语言,转写后导出 JSON 用于后续分析或编辑。
- 视频创作者:将 YouTube 视频的音频通过 URL 导入,快速获取文字稿,再导出为 SRT 用于字幕添加。
- 会议记录:在会议中使用浏览器录音功能,实时转写会议内容,结束后导出 TXT 存档,方便后续检索。
- 语言学习者:上传外语音频,利用自动语言检测功能获得转写文本,辅助听力和发音练习。
如何使用Whisper Web?
- 首次使用前,确保浏览器支持 WebGPU(如 Chrome 最新版),打开 Whisper Web 网页后,系统会自动下载模型(约1-2GB,建议在Wi-Fi环境下)。
- 选择输入方式:点击“From file”上传本地音频文件,或点击“Record”用麦克风实时录音,或粘贴音频 URL。
- 等待转写完成:根据文件大小和 GPU 性能,转写时间可能不同。免费版单次限制20分钟,超出需升级为 Unlimited。
- 检查转写结果:页面会显示逐段文字,可手动调整标点或分段。
- 导出文件:选择 TXT(纯文本)、SRT(字幕)、VTT(网页字幕)或 JSON(结构化数据)格式下载。
- 如需处理超过20分钟的大文件,需订阅 Unlimited 计划(每月10美元年付或20美元月付),文件将上传至云端处理。