
什么是Context.dev?
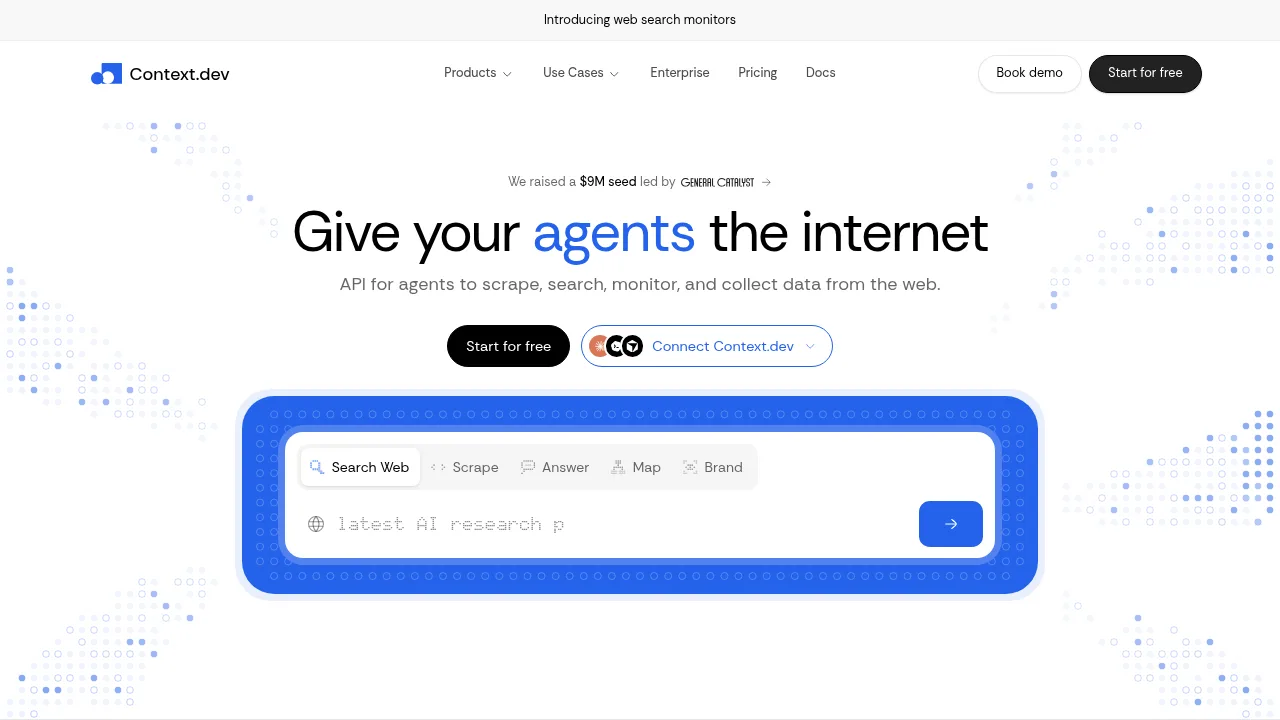
Context.dev 是一款专为 AI Agent 设计的 Web 数据基础设施 API,提供网页抓取、搜索、监控及品牌数据检索功能。该服务通过单一接口将实时网络内容转化为 Markdown、结构化 JSON 或截图,适用于需要动态更新知识库的应用场景。用户注册后可立即获取 API Key,免费层级包含每月 1,000 个积分且无需绑定信用卡。
Context.dev的核心功能有哪些?
- 多格式页面抓取将任意 URL 或 PDF 转换为 Markdown、HTML、结构化字段、图片或截图,单次请求即可返回多种格式。
- 自适应反爬处理自动执行 JavaScript 渲染、代理升级及重试策略,以应对反机器人保护机制,确保高成功率获取完整页面内容。
- Web 与新闻搜索针对 AI Agent 优化,返回带有清洁页面内容的排名结果,而非仅链接列表,支持实时网络信息检索。
- 站点映射与批量抓取发现域名下的所有 URL(含标题和描述),或通过批处理任务在后台抓取数千个 URL 或整个网站。
- 结构化问答生成接收研究问题并返回符合指定 JSON 结构的回答及来源 URL,支持 Fast 和 Ultra 两种模式。
- 变更监控按预定计划监视网页价格、内容或页面变化,并通过 Webhook 发送更新通知。
Context.dev的使用案例有哪些?
- RAG 管道增强利用 Scrape 和 Crawl 收集最新网页内容,结合 Monitors 保持检索索引的实时性,为 RAG 系统提供新鲜数据源。
- 自动化入职表单填充根据用户工作邮箱域名预填公司信息字段,简化新用户注册流程并提高完成率。
- 企业实体数据富化将公司引用或人员标识符连接至品牌档案和人物数据,用于 CRM 系统的客户资料完善。
如何使用Context.dev?
- 获取凭证访问 context.dev/auth.md 注册账户并获取 API Key,AI Agent 可通过此链接程序化注册。
- 选择接入方式使用官方 SDK(TypeScript, Python, Ruby, Go, PHP)、CLI 或 MCP 服务器进行集成。
- 配置请求参数调用
web.scrape等端点时,指定目标 URL 及所需输出格式(如 markdown, screenshot)。 - 处理响应数据解析返回的结构化数据或文件链接,将其注入应用逻辑或存储至数据库。
Context.dev定价信息:
- Free每月 1,000 个 API 积分(约等于 1,000 次标准抓取),包含 10K 一次性 Logo Link 请求,无需信用卡,并发限制为 2。
- Developer$20/月,并发限制为 10,适合初步工作流测试。
- Pro$90/月,并发限制为 100,适合稳定的生产环境使用。
- Growth$300/月,并发限制为 250,提供介于 Pro 和 Scale 之间的容量。
- Scale$500/月,并发限制为 500,支持高流量及自助式 SSO/SAML。
- Scale 2.5M$950/月,适用于更高量级的需求。
- Enterprise针对超过 2.5M 积分/月、自定义限额、年度发票或安全采购审查的团队,需联系销售。
- 积分消耗规则基础抓取 1 积分;浏览器操作加 1 积分;成功提取 JSON 加 4 积分;Highlights/Product 加 1 积分;PDF OCR 每页加 1 积分;Brand/Styleguide 10 积分;Answers Fast 10 积分/Ultra 100 积分;People Search 10 积分/次;Enrich 20 积分/匹配。