ModelsLabとは何ですか?
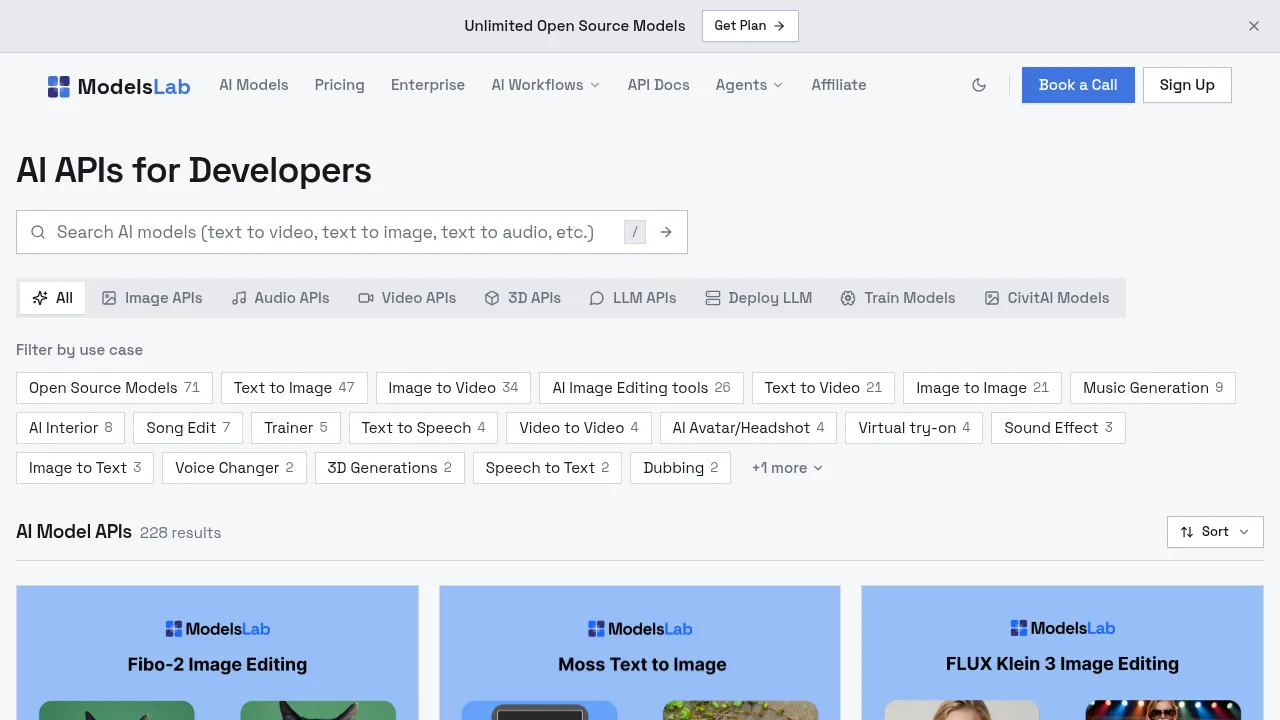
ModelsLabは、画像、動画、音声、3D、LLMなどの生成AIモデルをAPI経由で提供する開発者向けプラットフォームです。オープンソースおよびクローズドソースの228以上のモデルから選択し、テキストプロンプトや既存メディアを入力として出力を得られます。利用にはアカウント登録が必要であり、モデルごとに異なる制限や仕様があります。
ModelsLabの特徴は何ですか?
- テキストから画像への生成FLUX 3 KleinやQwen Image 2.1などのモデルを使い、自然言語のプロンプトから最大4K解像度の画像を作成します。
- 画像編集機能Fibo-2やIdeogram 4.5などを利用し、背景変更、オブジェクト削除、バウンディングボックス指定による部分編集が可能です。
- テキストから音声・音楽への変換Drama-3で感情表現のある音声を生成したり、Eleven V4で90以上の言語に対応したテキスト読み上げを実行したりできます。
- 音声からテキストへの転写Speech to Text APIを通じて、音声ファイルをテキストデータに変換します。
- 3Dおよび動画生成テキストや画像入力から3Dアセットや動画を生成するAPIを提供し、Image to Video変換もサポートします。
- 開発者向けツールCLI、SDKs、MCP Server、Agents Control Planeなどのインターフェースを用意し、ワークフローのカスタマイズやエージェント制御に対応します。
ModelsLabの使用例は何ですか?
- コンテンツ制作動画ナレーション用にテキストから音声を生成したり、ストーリーボード作成のために画像から動画を生成したりする場面。
- 画像の後処理既存の写真の背景を交換したり、特定領域のみを修正して視覚的な品質を向上させる作業。
- アプリケーション統合Webサイトやアプリに画像生成や音声認識機能を組み込むため、RESTful APIを呼び出す開発環境での利用。